Maths
Agro-VétoBCPST2026
# Agro-Véto BCPST — Mathématiques 2026 · Corrigé brut
*Corrigé rédigé par IA (La Belle Copie), non officiel. Signalez toute erreur.*
Épreuve « Méthodes de calcul et raisonnement », durée 2 h, sans calculatrice. Toutes les parties sont indépendantes, sauf la question 24.
## Partie I : Approximation de la loi de Poisson
On suppose $N\ge\lambda$, pour que $\lambda/N\in\,]0,1]$ soit une probabilité. Cette hypothèse est sans conséquence, car on fait ensuite tendre $N$ vers $+\infty$.
### 1.
Pour $i\in\{1,\dots,N\}$, notons $B_i$ la variable qui vaut $1$ si la $i$-ème bactérie devient résistante, et donc survit, et $0$ sinon. Chaque $B_i$ suit la loi de Bernoulli $\mathcal B(\lambda/N)$, et les $B_i$ sont mutuellement indépendantes par hypothèse. On a $X_N=\sum_{i=1}^N B_i$. C'est une somme de $N$ variables de Bernoulli indépendantes de même paramètre, donc :
$$\boxed{X_N\sim\mathcal B\!\left(N,\tfrac{\lambda}{N}\right),\qquad \forall k\in\{0,\dots,N\},\ \ \mathbb P(X_N=k)=\binom Nk\left(\frac\lambda N\right)^k\left(1-\frac\lambda N\right)^{N-k}.}$$
### 2.
Soit $k\in\mathbb N$ fixé. Pour $N>\lambda$, on a $0<1-\lambda/N<1$, d'où
$$\left(1-\frac\lambda N\right)^{N-k}=\exp\!\left[(N-k)\ln\!\left(1-\frac\lambda N\right)\right].$$
Quand $N\to+\infty$, $\lambda/N\to0$, donc $\ln(1-\lambda/N)\sim-\lambda/N$, et :
$$(N-k)\ln\!\left(1-\frac\lambda N\right)\sim N\cdot\left(-\frac\lambda N\right)=-\lambda .$$
Par continuité de l'exponentielle :
$$\boxed{\lim_{N\to+\infty}\left(1-\frac\lambda N\right)^{N-k}=e^{-\lambda}.}$$
### 3.
Soit $k\in\mathbb N$ fixé et $N\ge\max(k,\lambda)$. On écrit $\binom Nk=\frac{N(N-1)\cdots(N-k+1)}{k!}$, ce qui donne :
$$\mathbb P(X_N=k)=\underbrace{\prod_{j=0}^{k-1}\left(1-\frac jN\right)}_{c_N}\cdot\frac{\lambda^k}{k!}\cdot\left(1-\frac\lambda N\right)^{N-k}.$$
Le facteur $c_N$ est un produit d'un nombre **fixe** $k$ de facteurs, qui tendent chacun vers $1$, donc $c_N\to1$. Par la question 2, le dernier facteur tend vers $e^{-\lambda}$. Par produit de limites :
$$\boxed{\lim_{N\to+\infty}\mathbb P(X_N=k)=e^{-\lambda}\frac{\lambda^k}{k!}.}$$
### 4.
Si $X\sim\mathcal P(\mu)$ avec $\mu>0$, alors $\mathbb E(X)=\mathbb V(X)=\mu$. Comme $\mathbb E(X)\neq0$, on peut diviser :
$$\boxed{\frac{\mathbb V(X)}{\mathbb E(X)}=1.}$$
Ce rapport ne dépend pas du paramètre.
## Partie II : Inégalités de concentration
### 5.
Soit $X$ discrète, positive, admettant une espérance, et soit $a>0$. Par définition de l'espérance, la série ci-dessous converge absolument :
$$\mathbb E(X)=\sum_{x\in X(\Omega)}x\,\mathbb P(X=x).$$
On sépare cette somme selon que $x\le a$ ou $x>a$.
- Les termes avec $x\le a$ sont positifs, car $x\ge0$. On peut donc les retirer en minorant.
- Les termes avec $x>a$ vérifient $x\,\mathbb P(X=x)\ge a\,\mathbb P(X=x)$.
On obtient :
$$\mathbb E(X)\ \ge\sum_{x\in X(\Omega),\,x>a}x\,\mathbb P(X=x)\ \ge\ a\sum_{x\in X(\Omega),\,x>a}\mathbb P(X=x)=a\,\mathbb P(X>a).$$
La dernière égalité vient de ce que $\{X>a\}$ est la réunion disjointe, au plus dénombrable, des $\{X=x\}$ pour $x>a$ (σ-additivité). Comme $a>0$ :
$$\boxed{\mathbb P(X>a)\le\frac{\mathbb E(X)}a.}$$
### 6.
Soit $t\ge0$.
**Cas $t=0$.** On a $Z_0=1$ et $\psi(0)=\ln1=0$. L'inégalité s'écrit $\mathbb P(X>a)\le1$, ce qui est vrai.
**Cas $t>0$.** La fonction $u\mapsto e^{tu}$ est strictement croissante, donc $\{X>a\}=\{Z_t>e^{ta}\}$. La variable $Z_t$ est positive et admet une espérance, puisque $\psi(t)$ est définie. On applique Markov (question 5) à $Z_t$ avec le seuil $e^{ta}>0$ :
$$\mathbb P(X>a)=\mathbb P(Z_t>e^{ta})\le\frac{\mathbb E(Z_t)}{e^{ta}}=e^{\psi(t)}e^{-ta}.$$
Dans les deux cas :
$$\boxed{\forall t\ge0,\quad \mathbb P(X>a)\le e^{\psi(t)-ta}.}$$
### 7.a.
On a $X(\Omega)=\mathbb N$ et $\mathbb P(X=k)=e^{-\lambda}\lambda^k/k!$. Soit $t\ge0$. Par le théorème de transfert, $Z_t=e^{tX}$ admet une espérance si et seulement si la série à termes positifs $\sum_k e^{tk}e^{-\lambda}\lambda^k/k!$ converge. Or
$$\sum_{k=0}^{+\infty}e^{tk}e^{-\lambda}\frac{\lambda^k}{k!}=e^{-\lambda}\sum_{k=0}^{+\infty}\frac{(\lambda e^t)^k}{k!}=e^{-\lambda}e^{\lambda e^t}$$
et la série exponentielle converge pour tout réel. Donc $\mathbb E(Z_t)=e^{\lambda(e^t-1)}>0$, et $\psi$ est bien définie sur $\mathbb R_+$ :
$$\boxed{\forall t\ge0,\quad\psi(t)=\lambda\,(e^t-1).}$$
### 7.b.
Par 6 et 7.a, on a $\mathbb P(X>a)\le e^{\varphi(t)}$ pour tout $t\ge0$, avec $\varphi(t)=\lambda(e^t-1)-ta$.
La fonction $\varphi$ est dérivable et $\varphi'(t)=\lambda e^t-a$. Cette dérivée est positive si et seulement si $t\ge t^*:=\ln(a/\lambda)$. Comme $\lambda\le a$, on a $t^*\ge0$. La fonction $\varphi$ décroît donc sur $[0,t^*]$, puis croît sur $[t^*,+\infty[$, et son minimum sur $\mathbb R_+$ vaut :
$$\varphi(t^*)=\lambda\left(\frac a\lambda-1\right)-a\ln\frac a\lambda=a-\lambda-a\ln a+a\ln\lambda .$$
En prenant $t=t^*$ dans l'inégalité de la question 6 :
$$\boxed{\lambda\le a\ \Longrightarrow\ \mathbb P(X>a)\le\exp\left(a\ln\lambda-a\ln a+a-\lambda\right).}$$
### 7.c.
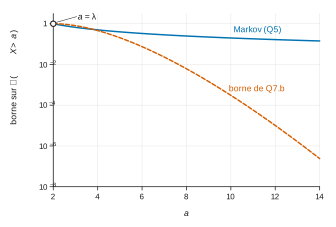
Ici $\mathbb E(X)=\lambda$. Les deux bornes valent :
- borne de Markov : $B_5(a)=\lambda/a$ ;
- borne de la question 7.b, pour $a\ge\lambda$ : $B_7(a)=\exp\left(-a\ln\frac a\lambda+a-\lambda\right)$.
Le logarithme de leur rapport vaut :
$$\ln\frac{B_7(a)}{B_5(a)}=-a\ln\frac a\lambda+a-\lambda+\ln\frac a\lambda=-(a-1)\ln\frac a\lambda+a-\lambda\underset{a\to+\infty}{\sim}-a\ln a\longrightarrow-\infty,$$
car $a=o(a\ln a)$. Donc $B_7(a)/B_5(a)\to0$.
**Lorsque $a\to+\infty$, la borne de la question 7.b est la meilleure : $B_7(a)=o(B_5(a))$.** Elle décroît comme $e^{-a\ln a}$, alors que la borne de Markov décroît seulement en $1/a$.
## Partie III : Étude d'un endomorphisme
### 8.
Soit $\nu>0$, et soit $P=\sum_{j=0}^n a_js^j$. Pour $s\ge0$, on a $|P(s)|\le\sum_j|a_j|s^j$. Par croissances comparées, $s^je^{-s/(2\nu)}\to0$ quand $s\to+\infty$, pour chaque $j$. Donc $|P(s)|e^{-s/(2\nu)}\to0$.
Par définition de la limite, appliquée avec $\varepsilon=1$, il existe $M\ge0$ tel que $|P(s)|e^{-s/(2\nu)}\le1$ pour $s>M$. En multipliant par $e^{-s/(2\nu)}>0$ :
$$\boxed{\exists M\ge0,\ \forall s>M,\quad |P(s)|\,e^{-s/\nu}\le e^{-s/(2\nu)}.}$$
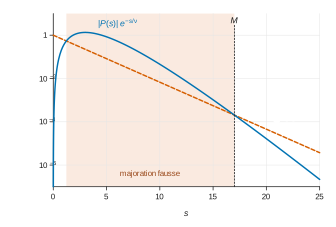
La fonction $s\mapsto P(s)e^{-s/\nu}$ est continue sur $[0,+\infty[$, et le seul problème de convergence est en $+\infty$. Sur $[M,+\infty[$, sa valeur absolue est majorée par $e^{-s/(2\nu)}$, dont l'intégrale converge :
$$\int_M^{+\infty}e^{-s/(2\nu)}\,\mathrm ds=2\nu e^{-M/(2\nu)}.$$
Par comparaison de fonctions positives, l'intégrale $\int_M^{+\infty}P(s)e^{-s/\nu}\,\mathrm ds$ converge absolument, donc converge. Sur le segment $[0,M]$, l'intégrale existe par continuité. Par la relation de Chasles, **$L_P(\nu)$ est bien défini**.
### 9.
Posons $J_k=\int_0^{+\infty}s^ke^{-s/\nu}\,\mathrm ds$, intégrale convergente par la question 8.
On a $J_0=\left[-\nu e^{-s/\nu}\right]_0^{+\infty}=\nu$.
Pour $k\ge1$ et $A>0$, une intégration par parties sur le segment $[0,A]$ donne :
$$\int_0^As^ke^{-s/\nu}\,\mathrm ds=\left[-\nu s^ke^{-s/\nu}\right]_0^A+k\nu\int_0^As^{k-1}e^{-s/\nu}\,\mathrm ds .$$
Par croissances comparées, $A^ke^{-A/\nu}\to0$. En faisant $A\to+\infty$, on obtient $J_k=k\nu J_{k-1}$. Par récurrence, $J_k=k!\,\nu^{k+1}$, d'où :
$$\boxed{\frac1\nu\int_0^{+\infty}s^ke^{-s/\nu}\,\mathrm ds=k!\,\nu^k.}$$
Si $P=\sum_{k=0}^n a_kX^k$, la linéarité de l'intégrale s'applique, car on a une somme finie d'intégrales convergentes :
$$\boxed{L_P(\nu)=\sum_{k=0}^n k!\,a_k\,\nu^k.}$$
### 10.
L'écriture $P=\sum_{k=0}^d a_kX^k$ dans la base $(1,X,\dots,X^d)$ est unique, donc $L$ est bien définie. Son image $\sum k!\,a_kX^k$ est encore de degré au plus $d$, donc $L$ va de $\mathbb R_d[X]$ dans $\mathbb R_d[X]$.
Pour la linéarité, soient $P=\sum a_kX^k$, $Q=\sum b_kX^k$ et $\mu\in\mathbb R$. Alors :
$$L(P+\mu Q)=\sum_{k=0}^dk!\,(a_k+\mu b_k)X^k=L(P)+\mu L(Q).$$
**$L$ est un endomorphisme de $\mathbb R_d[X]$.**
### 11.
$$\boxed{\dim\mathbb R_d[X]=d+1.}$$
### 12.
Par définition, $\ker L=\{P\in\mathbb R_d[X]\ :\ L(P)=0\}$.
Soit $P=\sum a_kX^k$. Un polynôme est nul si et seulement si tous ses coefficients sont nuls, donc $L(P)=0$ équivaut à $k!\,a_k=0$ pour tout $k$. Comme $k!\neq0$, cela équivaut à $a_k=0$ pour tout $k$. Donc :
$$\boxed{\ker L=\{0\}.}$$
### 13.
$L$ est un endomorphisme injectif (question 12) d'un espace de dimension finie (question 11). Par le théorème du rang, $\operatorname{rg}L=d+1-\dim\ker L=d+1$, donc $\operatorname{Im}L=\mathbb R_d[X]$.
**Oui, $L$ est surjectif**, et même bijectif. On le voit aussi directement : $\sum b_kX^k=L\left(\sum\frac{b_k}{k!}X^k\right)$.
### 14.
On a $L(1)=1$, $L(X)=X$, $L(X^2)=2X^2$ et $L(X^3)=6X^3$. Dans la base canonique $(1,X,X^2,X^3)$ :
$$\boxed{\operatorname{Mat}(L)=\begin{pmatrix}1&0&0&0\\0&1&0&0\\0&0&2&0\\0&0&0&6\end{pmatrix}.}$$
### 15.
Soit $P=\sum a_kX^k$ et $\mu\in\mathbb R$. Alors $L(P)=\mu P$ équivaut à $(k!-\mu)\,a_k=0$ pour tout $k\in\{0,\dots,d\}$.
- Si $\mu$ n'est égal à aucun des $k!$, la seule solution est $P=0$, et $\mu$ n'est pas valeur propre.
- Si $\mu=k_0!$, les solutions sont les $P$ dont les seuls coefficients non nuls sont ceux des $X^k$ tels que $k!=k_0!$.
Or $0!=1!=1$, et $k\mapsto k!$ est strictement croissante sur $\mathbb N^*$. On obtient :
$$\boxed{\operatorname{Sp}(L)=\{k!\ :\ 0\le k\le d\}=\{1,2,6,\dots,d!\},\qquad E_1(L)=\operatorname{Vect}(1,X),\qquad E_{k!}(L)=\operatorname{Vect}(X^k)\ \ (2\le k\le d).}$$
Pour $d=1$, on a $\operatorname{Sp}(L)=\{1\}$ et $L=\mathrm{id}$.
### 16.
Pour tout $d\in\mathbb N^*$, la base canonique est formée de vecteurs propres de $L$ : la matrice de $L$ dans cette base est $\mathrm{diag}(0!,1!,\dots,d!)$. De façon équivalente, la somme des dimensions des sous-espaces propres vaut $2+(d-1)=d+1$.
**$L$ est diagonalisable pour toute valeur de $d\in\mathbb N^*$.**
### 17.a.
L'application $\varphi:M\mapsto AM-MA$ est linéaire de $\mathcal M_3(\mathbb R)$ dans lui-même, puisque $\varphi(M+\mu N)=\varphi(M)+\mu\varphi(N)$ par distributivité du produit matriciel. Or $C(A)=\ker\varphi$. Un noyau est un sous-espace vectoriel, donc **$C(A)$ est un sous-espace vectoriel de $\mathcal M_3(\mathbb R)$**.
### 17.b.
On calcule les deux produits :
$$AM=\begin{pmatrix}0&0&0\\0&0&0\\g&h&k\end{pmatrix},\qquad MA=\begin{pmatrix}0&0&c\\0&0&f\\0&0&k\end{pmatrix}.$$
En identifiant les coefficients :
$$\boxed{M\in C(A)\iff c=f=g=h=0\iff M=\begin{pmatrix}a&b&0\\d&e&0\\0&0&k\end{pmatrix}.}$$
### 17.c.
Notons $E_{i,j}$ les matrices élémentaires.
$$\boxed{\text{Base : }(E_{1,1},E_{1,2},E_{2,1},E_{2,2},E_{3,3}),\qquad \dim C(A)=5.}$$
### 17.d.
Pour $\alpha,\beta\in\mathbb R$, $\alpha I_3+\beta A=\mathrm{diag}(\alpha,\alpha,\alpha+\beta)$. Tout élément de $\operatorname{Vect}(I_3,A)$ est donc diagonal.
Prenons $M_0=E_{1,2}$, matrice dont l'unique coefficient non nul est un $1$ en position $(1,2)$.
- On a $M_0\in C(A)$, car ses coefficients $c,f,g,h$ sont nuls (question 17.b).
- On a $M_0\notin\operatorname{Vect}(I_3,A)$, car son coefficient $(1,2)$ vaut $1\neq0$ alors que $M_0$ devrait être diagonale.
$$\boxed{E_{1,2}=\begin{pmatrix}0&1&0\\0&0&0\\0&0&0\end{pmatrix}\in C(A)\setminus\operatorname{Vect}(I_3,A).}$$
## Partie IV : Loi de Yule–Simon
### 18.
Soit $k\in\mathbb N$. La fonction $f_k:s\mapsto(1-e^{-s})^ke^{-(\nu+1)s}$ est continue sur $[0,+\infty[$. Pour $s\ge0$, on a $0\le1-e^{-s}<1$, donc :
$$0\le f_k(s)\le e^{-(\nu+1)s}.$$
De plus, $\int_0^{+\infty}e^{-(\nu+1)s}\,\mathrm ds=\frac1{\nu+1}$ converge, car $\nu+1>0$. Par comparaison de fonctions positives, **l'intégrale définissant $p_k$ converge**, et $0\le p_k\le\frac\nu{\nu+1}$.
### 19.
Soit $A>0$. On pose $t=e^{-s}$, changement de variable de classe $\mathcal C^1$ et strictement décroissant de $[0,A]$ sur $[e^{-A},1]$. On a $\mathrm dt=-t\,\mathrm ds$, $1-e^{-s}=1-t$ et $e^{-(\nu+1)s}=t^{\nu+1}$, d'où :
$$\int_0^A(1-e^{-s})^ke^{-(\nu+1)s}\,\mathrm ds=\int_{e^{-A}}^1t^{\nu+1}(1-t)^k\frac{\mathrm dt}t=\int_{e^{-A}}^1t^{\nu}(1-t)^k\,\mathrm dt .$$
La fonction $t\mapsto t^\nu(1-t)^k$ est continue sur le segment $[0,1]$, car $\nu>0$. Donc $x\mapsto\int_x^1t^\nu(1-t)^k\,\mathrm dt$ est continue en $0$. Comme $e^{-A}\to0$, on fait $A\to+\infty$ et on multiplie par $\nu$ :
$$\boxed{\forall k\in\mathbb N,\quad p_k=\nu\int_0^1t^\nu(1-t)^k\,\mathrm dt.}$$
### 20.a.
C'est une somme géométrique de raison $1-t$, qui vaut $1$ seulement pour $t=0$.
$$\boxed{\sum_{k=0}^N(1-t)^k=\begin{cases}\dfrac{1-(1-t)^{N+1}}{t}&\text{si }t\in\,]0,1],\\[2mm] N+1&\text{si }t=0.\end{cases}}$$
### 20.b.
Comme $\nu-1>0$, on a $0\le t^{\nu-1}\le1$ sur $[0,1]$. En multipliant par $(1-t)^{N+1}\ge0$, on obtient $0\le t^{\nu-1}(1-t)^{N+1}\le(1-t)^{N+1}$. Les deux fonctions sont continues sur $[0,1]$. Par croissance de l'intégrale sur un segment :
$$\boxed{\int_0^1t^{\nu-1}(1-t)^{N+1}\,\mathrm dt\le\int_0^1(1-t)^{N+1}\,\mathrm dt=\frac1{N+2}.}$$
### 20.c.
Par la question 19 et la linéarité de l'intégrale (somme finie) :
$$\sum_{k=0}^Np_k=\nu\int_0^1t^\nu\sum_{k=0}^N(1-t)^k\,\mathrm dt .$$
Par 20.a, sur $]0,1]$, on a $t^\nu\sum_{k=0}^N(1-t)^k=t^{\nu-1}\big(1-(1-t)^{N+1}\big)$. Les deux membres sont continus sur $[0,1]$ et valent $0$ en $t=0$, car $\nu>1$. L'égalité vaut donc sur tout $[0,1]$, et :
$$\sum_{k=0}^Np_k=\nu\int_0^1t^{\nu-1}\,\mathrm dt-\nu\int_0^1t^{\nu-1}(1-t)^{N+1}\,\mathrm dt=1-R_N,\qquad R_N=\nu\int_0^1t^{\nu-1}(1-t)^{N+1}\,\mathrm dt.$$
Par 20.b, $0\le R_N\le\frac\nu{N+2}\to0$. La série $\sum p_k$ converge donc et sa somme vaut $1$. Comme de plus $p_k\ge0$ (question 18), la suite $(p_k)_{k\in\mathbb N}$ est une loi de probabilité sur $\mathbb N$. **Il existe donc une variable aléatoire discrète $X$ telle que $\mathbb P(X=k)=p_k$ pour tout $k\in\mathbb N$.**
## Partie V : Calculs de moments
Ici $\nu>2$.
### 21.a.
Soient $n,p\in\mathbb N$. Les fonctions $u:t\mapsto\frac{t^{n+1}}{n+1}$ et $v:t\mapsto(1-t)^{p+1}$ sont de classe $\mathcal C^1$ sur $[0,1]$. On intègre par parties :
$$I_{n,p+1}=\left[\frac{t^{n+1}}{n+1}(1-t)^{p+1}\right]_0^1+\frac{p+1}{n+1}\int_0^1t^{n+1}(1-t)^p\,\mathrm dt .$$
Le crochet est nul aux deux bornes, car $n+1\ge1$ et $p+1\ge1$. Donc :
$$\boxed{(n+1)\,I_{n,p+1}=(p+1)\,I_{n+1,p}.}$$
### 21.b.
On montre par récurrence sur $p$ la propriété $\mathcal H_p$ : « pour tout $n\in\mathbb N$, $I_{n,p}=\frac{n!\,p!}{(n+p+1)!}$ ».
- **Initialisation.** $I_{n,0}=\frac1{n+1}=\frac{n!\,0!}{(n+1)!}$, donc $\mathcal H_0$ est vraie.
- **Hérédité.** Supposons $\mathcal H_p$ vraie et soit $n\in\mathbb N$. On applique 21.a, puis $\mathcal H_p$ à l'entier $n+1$ :
$$I_{n,p+1}=\frac{p+1}{n+1}\cdot\frac{(n+1)!\,p!}{(n+p+2)!}=\frac{n!\,(p+1)!}{(n+(p+1)+1)!}.$$
Donc $\mathcal H_{p+1}$ est vraie. Par récurrence :
$$\boxed{\forall n,p\in\mathbb N,\quad I_{n,p}=\frac{n!\,p!}{(n+p+1)!}.}$$
### 21.c.
$$(N+1)\int_0^1t(1-t)^N\,\mathrm dt=(N+1)\,I_{1,N}=(N+1)\frac{N!}{(N+2)!}=\frac1{N+2},$$
$$\boxed{\lim_{N\to+\infty}(N+1)\int_0^1t(1-t)^N\,\mathrm dt=0.}$$
### 22.a.
Soit $N\in\mathbb N$. Sur l'intervalle ouvert $]0,2[$, qui contient $]0,1]$, on a par 20.a (la formule de la somme géométrique y vaut, car $1-t\neq1$) :
$$\sum_{k=0}^N(1-t)^k=\frac{1-(1-t)^{N+1}}t .$$
On dérive les deux membres par rapport à $t$. À gauche, on obtient $-\sum_{k=1}^Nk(1-t)^{k-1}$. À droite :
$$\frac{(N+1)(1-t)^N\,t-\big(1-(1-t)^{N+1}\big)}{t^2}=\frac{(N+1)(1-t)^N}t-\frac1{t^2}+\frac{(1-t)^{N+1}}{t^2}.$$
En changeant les signes :
$$\boxed{\forall t\in\,]0,1],\quad\sum_{k=1}^Nk(1-t)^{k-1}=\frac1{t^2}-\frac{(1-t)^{N+1}}{t^2}-\frac{(N+1)(1-t)^N}t.}$$
### 22.b.
Comme $\nu>2$, la fonction $t\mapsto\nu t^{\nu-2}(1-t)$ est continue sur $[0,1]$ :
$$\int_0^1\nu\,t^\nu(1-t)\frac1{t^2}\,\mathrm dt=\nu\int_0^1\left(t^{\nu-2}-t^{\nu-1}\right)\mathrm dt=\nu\left(\frac1{\nu-1}-\frac1\nu\right),$$
$$\boxed{\int_0^1\nu\,t^\nu(1-t)\frac1{t^2}\,\mathrm dt=\frac1{\nu-1}.}$$
### 22.c.
Les termes $kp_k$ sont positifs. $X$ admet donc une espérance si et seulement si la suite des sommes partielles $\Sigma_N=\sum_{k=1}^Nkp_k$ converge.
Par la question 19 et la linéarité (somme finie), en factorisant $(1-t)$ puis en appliquant 22.a sur $]0,1]$ :
$$\Sigma_N=\nu\int_0^1t^\nu(1-t)\sum_{k=1}^Nk(1-t)^{k-1}\,\mathrm dt=T-R_N^{(1)}-R_N^{(2)}.$$
Les trois termes valent :
$$T=\nu\int_0^1t^{\nu-2}(1-t)\,\mathrm dt,\qquad R_N^{(1)}=\nu\int_0^1t^{\nu-2}(1-t)^{N+2}\,\mathrm dt,\qquad R_N^{(2)}=\nu(N+1)\int_0^1t^{\nu-1}(1-t)^{N+1}\,\mathrm dt.$$
Les trois intégrandes sont continues sur $[0,1]$, car $\nu-2>0$, ce qui justifie la séparation de l'intégrale. Les égalités ont lieu sur $]0,1]$ et s'étendent en $0$ par continuité.
- Par 22.b, $T=\frac1{\nu-1}$.
- Comme $0\le t^{\nu-2}\le1$, on a $0\le R_N^{(1)}\le\nu\int_0^1(1-t)^{N+2}\,\mathrm dt=\frac\nu{N+3}\to0$.
- Comme $\nu-1>1$, on a $t^{\nu-1}\le t$ sur $[0,1]$. Avec $(1-t)^{N+1}\le(1-t)^N$, on obtient $0\le R_N^{(2)}\le\nu\,(N+1)\int_0^1t(1-t)^N\,\mathrm dt$, qui tend vers $0$ par 21.c.
Donc $\Sigma_N\to\frac1{\nu-1}$, la série $\sum kp_k$ converge, et **$X$ admet une espérance** :
$$\boxed{\mathbb E(X)=\frac1{\nu-1}.}$$
### 23.a.
Pour $t\in\,]0,1]$, on a $\nu t^\nu(1-t)^2\frac2{t^3}=2\nu\left(t^{\nu-3}-2t^{\nu-2}+t^{\nu-1}\right)$.
Comme $\nu-3>-1$, l'intégrale $\int_0^1t^{\nu-3}\,\mathrm dt$ converge. C'est une intégrale de Riemann en $0$, généralisée si $\nu<3$, et elle vaut $\frac1{\nu-2}$. Les deux autres termes sont continus sur $[0,1]$. Donc :
$$\mathbb E((X-1)X)=2\nu\left(\frac1{\nu-2}-\frac2{\nu-1}+\frac1\nu\right)=2\nu\cdot\frac{\nu(\nu-1)-2\nu(\nu-2)+(\nu-1)(\nu-2)}{\nu(\nu-1)(\nu-2)}=2\nu\cdot\frac{2}{\nu(\nu-1)(\nu-2)},$$
$$\boxed{\mathbb E((X-1)X)=\frac4{(\nu-1)(\nu-2)}.}$$
### 23.b.
On a $X^2=(X-1)X+X$. Les variables $(X-1)X$ (énoncé) et $X$ (question 22.c) admettent une espérance. Par linéarité, $X^2$ admet une espérance, donc $X$ admet un moment d'ordre 2 et par conséquent une variance. Par la formule de König–Huygens :
$$\mathbb V(X)=\mathbb E((X-1)X)+\mathbb E(X)-\mathbb E(X)^2=\frac4{(\nu-1)(\nu-2)}+\frac1{\nu-1}-\frac1{(\nu-1)^2}=\frac{4(\nu-1)+(\nu-1)(\nu-2)-(\nu-2)}{(\nu-1)^2(\nu-2)}.$$
Le numérateur vaut $\nu^2$, donc :
$$\boxed{\mathbb V(X)=\frac{\nu^2}{(\nu-1)^2(\nu-2)}.}$$
### 23.c.
Comme $\mathbb E(X)>0$ :
$$\frac{\mathbb V(X)}{\mathbb E(X)}=\frac{\nu^2}{(\nu-1)^2(\nu-2)}\cdot(\nu-1)=\frac{\nu^2}{(\nu-1)(\nu-2)}.$$
Le dénominateur $(\nu-1)(\nu-2)$ est strictement positif, car $\nu>2$. De plus, $\nu^2-(\nu-1)(\nu-2)=3\nu-2>0$. Donc :
$$\boxed{\frac{\mathbb V(X)}{\mathbb E(X)}=\frac{\nu^2}{(\nu-1)(\nu-2)}>1.}$$
### 24.
Les deux modèles se distinguent par l'indice de dispersion $\mathbb V(X)/\mathbb E(X)$ :
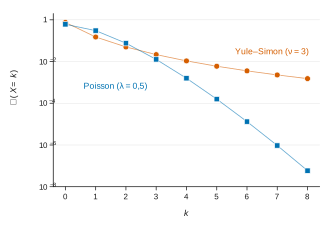
- dans la partie I (loi de Poisson), il vaut $1$ (question 4). Pour la binomiale exacte $\mathcal B(N,\lambda/N)$, il vaut $1-\lambda/N\le1$ ;
- dans la partie V (loi de Yule–Simon), il vaut $\frac{\nu^2}{(\nu-1)(\nu-2)}>1$ (question 23.c), quel que soit $\nu>2$.
À partir d'un échantillon $x_1,\dots,x_n$ (nombres de bactéries survivantes dans $n$ cultures indépendantes, menées dans les mêmes conditions), on calcule :
- la moyenne empirique $\bar x=\frac1n\sum x_i$, qui estime $\mathbb E(X)$ par la loi faible des grands nombres ;
- la variance empirique $s^2=\frac1{n-1}\sum(x_i-\bar x)^2$, estimation usuelle de $\mathbb V(X)$ ;
- puis l'indice empirique $\widehat D=s^2/\bar x$.
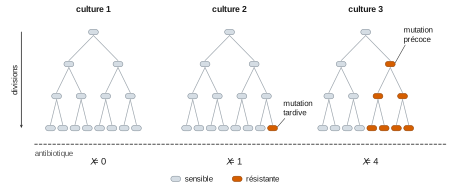
**Règle :** si $\widehat D$ est proche de $1$, on privilégie le modèle de la partie I (mutations induites par l'exposition). Si $\widehat D$ est nettement supérieur à $1$ (sur-dispersion), on privilégie le modèle de la partie V (mutations spontanées transmises à la descendance). « Nettement » s'apprécie en fonction de la taille de l'échantillon.
Aide sur le corrigé
Connectez-vous pour demander une explication.